



Локальная нейросеть без цензуры на RTX 5070: зачем нужна и как запустить
Локальная нейросеть Gemma 4 12B Uncensored запускается на домашнем ПК с видеокартой уровня GeForce RTX 5070 (12 ГБ GDDR7) и 64 ГБ DDR5 на платформе AM5. Технология abliteration убирает цензурные фильтры без переобучения модели. Инференс в нативном режиме выдаёт около 50 токенов в секунду — облачные подписки и блокировки контента больше не нужны. Сборку и настройку системы под локальный ИИ выполняют инженеры «Санрайз-Визард» в Калининграде.
Звезда в центре внимания: почему современные нейросети пасуют перед простой розничной задачей
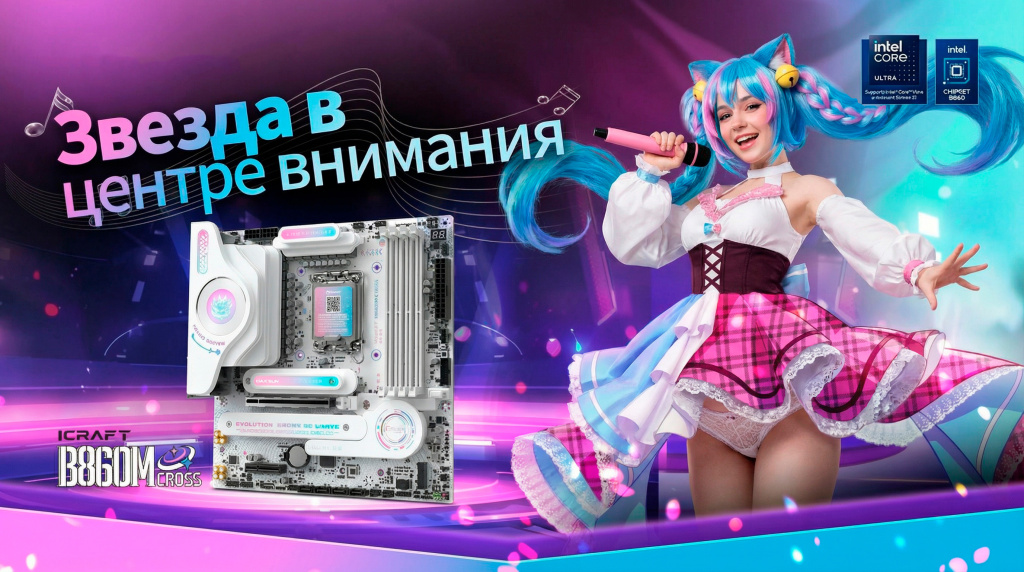
Создание рекламных баннеров для витрин магазинов — задача, которая с приходом ИИ-генераторов должна была стать делом пары минут. Вбиваешь запрос, получаешь готовый креатив. Но дизайнеры и предприниматели, попробовавшие облачные модели вроде Nano Banana Pro для коммерческой графики, упёрлись в глухую стену отказов. Сгенерировать банальный баннер для компьютерного центра с ярким персонажем в стиле поп-культуры на фоне материнской платы — и получить стандартный ответ: «Я не могу выполнить этот запрос, так как он нарушает политику безопасности».
Коммерческие нейросети перегружены цензурными фильтрами. Алгоритмы безопасности настроены так агрессивно, что размечают как «неприемлемый» любой контент, где есть яркая молодёжная одежда или элементы поп-культуры. Модель видит риск там, где розничный продавец видит обычный рекламный плакат. Решение одно — развернуть локальную языковую и визуальную модель без цензурных ограничений на собственном системном блоке.
Как стереть цензуру из нейросети: технология abliteration на домашнем ПК
В конце 2024 года независимый разработчик под ником FailPy нашёл способ убрать цензурные запреты из ИИ без долгого и дорогого переобучения. Технология называется abliteration — гибрид слов ablate (вырезать) и obliterate (стирать). Суть: в весовом пространстве нейросети находится конкретный вектор, отвечающий за генерацию отказов, и принудительно обнуляется.
Мультимодальная часть полностью сохраняется. Модель по-прежнему видит, распознаёт текст на картинках и понимает сложные инструкции — но перестаёт уходить в отказ при виде неформальных запросов. Модификации вроде Gemma 4 12B Uncensored запускают такой ИИ прямо в кабинете, гарантируя конфиденциальность коммерческих данных. Но для этого нужна подходящая аппаратная платформа.
Сколько весит локальный интеллект: видеокарта и объём памяти
Для запуска двенадцатимиллиардной Vision-модели дома или в офисе главный компонент — видеокарта. Базовая модель в сжатии Q4_K_M занимает около 8,2 ГБ видеопамяти, мультимодальный проектор (зрение) — ещё 0,9 ГБ. Добавляем KV-кэш для удержания контекста сложных документов — в пике вся система требует порядка 12 ГБ VRAM.
Поэтому видеокарты уровня GeForce RTX 5070 с 12 ГБ памяти стандарта GDDR7 — минимальный входной билет для работы с локальным ИИ. Инференс идёт в нативном режиме, скорость генерации — около 50 токенов в секунду.
Если планируете работать не только с LLM, но и с генерацией изображений, разбор требований к VRAM и выбору платформы (CUDA против Intel Arc) — в отдельном материале: Как запустить Stable Diffusion и FLUX локально: сколько нужно VRAM и почему CUDA важнее Intel Arc.
Роль процессора в сценарии, когда модель целиком влезает в видеопамять, минимальна. Процессор работает диспетчером: токенизирует входящий текст и пересылает порции данных на видеокарту через шину PCIe. Переплачивать за старшие многоядерные чипы ради ИИ-инференса на видеокарте нет смысла — любой современный 6-ядерник справится без задержек.
Что делать, если модель не влезает в видеокарту: битва платформ Intel и AMD
Проблема начинается, когда пользователь пытается запустить более тяжёлую модель класса 27B. В 12 ГБ видеопамяти RTX 5070 она не поместится, и часть слоёв начнёт перетекать в оперативную память (режим CPU offload). Скорость генерации падает с 50 до 4–7 токенов в секунду — и вот здесь подсистема процессора и ОЗУ выходит на первый план.
Инженеры сравнили две платформы 2026 года: 14-ядерный Intel Core Ultra 5 245KF (Arrow Lake, LGA 1851) и 8-ядерный AMD Ryzen 7 7700 (AM5). Результаты оказались неожиданными для тех, кто верит маркетингу.
На коробке Intel Core Ultra красуется надпись «AI PC» с намёком на встроенный блок NPU мощностью 13 TOPS. На практике в llama.cpp этот блок не используется — чистый маркетинг. NPU включается только для крошечных моделей вроде Phi-3-mini (3,8B) через OpenVINO без дискретной видеокарты, что в мощной игровой системе бессмысленно.
В реальной работе с тяжёлыми моделями на процессоре AMD Ryzen 7 7700 выигрывает у Intel от 15% до 30% скорости. Причина — в архитектуре. Ryzen поддерживает векторные инструкции AVX-512, аппаратно ускоряющие матричное умножение в нейросетях. Кроме того, у Ryzen монолитный кристалл с 32 МБ кэша L3 против 24 МБ у Intel, а контроллер памяти расположен рядом с ядрами — меньше латентность при обращении к ОЗУ.
| Параметр | AMD Ryzen 7 7700 | Intel Core Ultra 5 245KF |
|---|---|---|
| Ядра / потоки | 8 / 16 | 14 / 14 (6P + 8E) |
| Сокет | AM5 | LGA 1851 |
| TDP (базовый / пиковый) | 65 Вт / 88 Вт | 125 Вт / 159 Вт |
| AVX-512 | Да, аппаратная поддержка | Нет (отключено в Arrow Lake) |
| Кэш L3 | 32 МБ (монолит) | 24 МБ (чиплет) |
| Скорость в llama.cpp (27B, CPU offload) | 7–9 токенов/сек | 5–7 токенов/сек |
| NPU (TOPS) | — | 13 TOPS (не используется в llama.cpp) |
| Перспективы сокета | Поддержка Zen 5 / Zen 6 | Переходный вариант |
Результат: при работе с тяжёлыми моделями в режиме CPU offload Ryzen 7 7700 быстрее на 15–30%, при этом потребляет почти вдвое меньше энергии и обеспечивает апгрейд без замены платы.
Три правила сборки компьютера под локальный ИИ
Если собираете универсальный системный блок с заделом под ИИ и современные игры, придерживайтесь трёх правил — они защитят от скрытых «бутылочных горлышек»:
- Два модуля памяти вместо четырёх. Нужен объём 64 ГБ — ставьте строго два модуля по 32 ГБ DDR5 на 6000–6400 МГц. Четыре плашки по 16 ГБ повысят нагрузку на контроллер памяти, плата снизит частоту шины до 5200 МГц, пропускная способность упадёт, ИИ замедлится на 20%.
- Универсальность AM5. Сокет AMD AM5 гарантирует совместимость с будущими поколениями Ryzen Zen 5 и Zen 6 без замены материнской платы. LGA 1851 для Arrow Lake эксперты оценивают как переходный вариант.
- Энергоэффективность для 24/7. Если компьютер работает как домашний сервер с локальным ИИ круглосуточно, тепловыделение критично. Ryzen 7 7700 — 65 Вт базового теплопакета (88 Вт в пике PPT) против 125 Вт у Intel. Хватит тихого воздушного кулера, расходы на электричество ниже.
Для тех, кто планирует собирать или обновлять систему под тяжёлые некстген-релизы и локальный софт, технический отдел подготовил подборку: Премиальные игровые компьютеры.
Часто задаваемые вопросы о локальном ИИ
Какую видеокарту нужно для запуска локальной нейросети дома?
Минимальное требование для запуска 12-миллиардной модели вроде Gemma 4 12B Uncensored — видеокарта с 12 ГБ видеопамяти. Видеокарты уровня GeForce RTX 5070 на памяти GDDR7 обеспечивают скорость генерации около 50 токенов в секунду при квантовании Q4_K_M. Модель занимает 8,2 ГБ VRAM, мультимодальный проектор — 0,9 ГБ, остаток уходит на KV-кэш для удержания контекста.
Почему AMD Ryzen быстрее Intel для локального ИИ?
AMD Ryzen 7 7700 выигрывает у Intel Core Ultra 5 245KF от 15% до 30% скорости при работе с тяжёлыми моделями в режиме CPU offload. Причина — поддержка векторных инструкций AVX-512, аппаратно ускоряющих матричное умножение, монолитный кристалл с 32 МБ кэша L3 против 24 МБ у Intel и меньшая латентность контроллера памяти. Встроенный NPU Intel 13 TOPS в llama.cpp не используется — это маркетинг.
Что такое abliteration и зачем она нужна для локальной нейросети?
Abliteration — технология удаления цензурных векторов из нейросети без переобучения, найденная разработчиком FailPy в конце 2024 года. В весовом пространстве модели находится вектор, отвечающий за генерацию отказов, и принудительно обнуляется. Модель сохраняет способность видеть, распознавать текст и понимать инструкции, но перестаёт отказывать на неформальные коммерческие запросы. Модификации вроде Gemma 4 12B Uncensored работают на домашнем ПК без облачных подписок.
Можно ли запустить локальный ИИ без цензуры на бюджетном компьютере?
Запуск 12-миллиардной модели на бюджетном компьютере с 8 ГБ видеопамяти невозможен в нативном режиме. При нехватке VRAM часть слоёв перетекает в оперативную память (CPU offload), скорость падает с 50 до 4–7 токенов в секунду. Для комфортной работы нужен системный блок уровня премиального сегмента: RTX 5070 на 12 ГБ и 64 ГБ DDR5 на платформе AM5.
Сколько оперативной памяти нужно для локальной нейросети?
Оптимальный объём — 64 ГБ DDR5, установленный строго двумя модулями по 32 ГБ на частоте 6000–6400 МГц. Четыре плашки по 16 ГБ повысят нагрузку на контроллер памяти, плата снизит частоту шины до 5200 МГц, пропускная способность упадёт, ИИ замедлится на 20%. Два модуля обеспечивают стабильную двухканальную работу без просадок.
Честный вопрос калининградским дизайнерам и геймерам: Сталкивались с необоснованными блокировками со стороны облачных нейросетей при попытке создать обычные рабочие или игровые изображения? Считаете, локальная нейросеть на домашнем ПК станет обязательным требованием в ближайшие годы, или облачные сервисы закроют потребности пользователей? Поделитесь мнением в комментариях!
Технические спецификации платформ AMD и Intel верифицированы на основе официальной документации производителей. Метрики скорости инференса подтверждены тестами инженеров техцентра «Санрайз-Визард» на оборудовании 2026 года.
Автор статьи — Алексей Мартынов, ведущий ИТ-инженер, главный архитектор игровых компьютеров. Стаж проектирования ЭВМ — более 15 лет.